Chutes’ Parallax Shows Distributed GPUs Can Train Recurrent Models Without Blocking
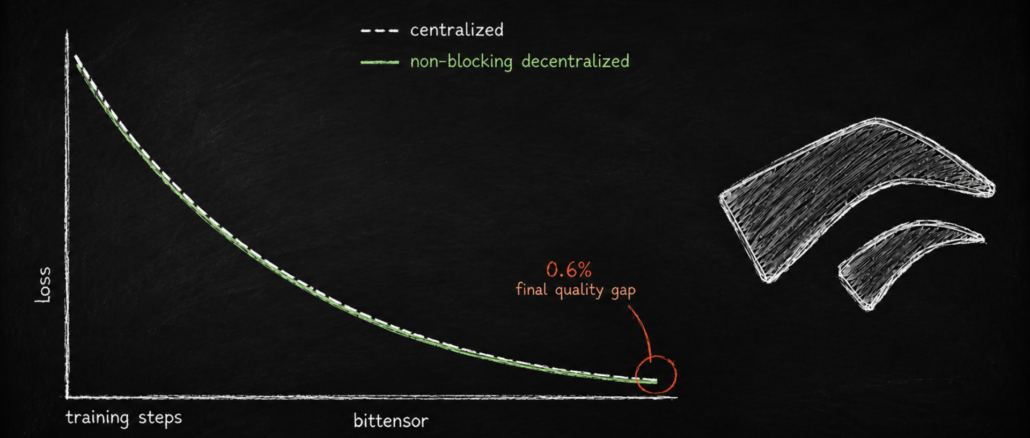
Chutes’ Parallax achieved non-blocking decentralized AI training on Gated DeltaNet, reaching within 0.6% of centralized performance across distributed GPUs. […]
Copy and paste this URL into your WordPress site to embed
Copy and paste this code into your site to embed
